Notatka · Modele lokalne · 6 min czytania
Do wielu zadań wcale nie potrzebujesz najlepszego modelu
Trzy komputery w domu, jeden otwarty model językowy uruchomiony lokalnie i sporo automatyzacji, które na nim działają. O tym, dlaczego do wielu zadań w firmie mniejszy model w zupełności wystarcza.
Jest jedna rzecz, którą mówię prawie każdemu, kto pyta mnie o sztuczną inteligencję w firmie: do bardzo wielu zadań wcale nie potrzebujesz ani najlepszego, ani największego modelu, jaki jest dostępny na rynku. Duże firmy technologiczne co jakiś czas wypuszczają nowy (zazwyczaj jeszcze mocniejszy) model i prawie za każdym razem próbują Cię przekonać, że to jest model, którego potrzebujesz i bez którego nie będziesz w stanie sobie poradzić. Ja uważam, że w wielu przypadkach nie jest to prawda. Spróbuję wyjaśnić, dlaczego.
Dlaczego największe modele działają w chmurze
Zacznijmy od tego, czego takie najlepsze modele potrzebują, żeby w ogóle działać. Przy największych modelach danych jest tak dużo, że potrzeba wielu wyspecjalizowanych kart obliczeniowych, do tego serwerów, które spinają je w jedną całość, chłodzenia, bo taki sprzęt wydziela ogromne ilości ciepła, przyłącza prądu o mocy, jakiej zwykłe biuro zazwyczaj nie ma, i ludzi, którzy to wszystko utrzymują. Postawienie czegoś takiego u siebie jest w teorii możliwe, ale biorąc pod uwagę realne koszty, wielkość potrzebnego pomieszczenia i moc przyłącza prądu, bardzo mało prawdopodobne. Dlatego takie modele działają w dużych centrach danych, a Ty korzystasz z nich przez internet, płacąc dostawcy za każde zapytanie. I na tym mógłbym skończyć, gdyby nie to, że wcale nie uważam tego za problem.
Co firmy naprawdę chcą automatyzować
Kiedy przyjrzeć się temu, co wiele firm faktycznie chce zautomatyzować, to w wielu przypadkach okazuje się, że nie są to zadania wymagające najmocniejszych modeli. Odczytanie danych z faktury i wpisanie ich do systemu, posortowanie wiadomości od klientów według tego, czego dotyczą, streszczenie długiego dokumentu, sprawdzenie, czy zgłoszenie jest kompletne, przepisanie notatek ze spotkania na porządny raport to zadania proste i powtarzalne, a z mojego doświadczenia wynika, że mniejsze modele potrafią zupełnie przyzwoicie sobie z nimi poradzić. Mniejsze modele są o wiele tańsze w utrzymaniu, a co się z tym wiąże, da się je uruchomić na sprzęcie znacznie bardziej osiągalnym i dostępnym dla wielu firm, a nawet osób prywatnych. Na przykład na komputerze, który może stać w firmie albo (jak u mnie) w domu.
Mój sprzęt do lokalnego modelu językowego
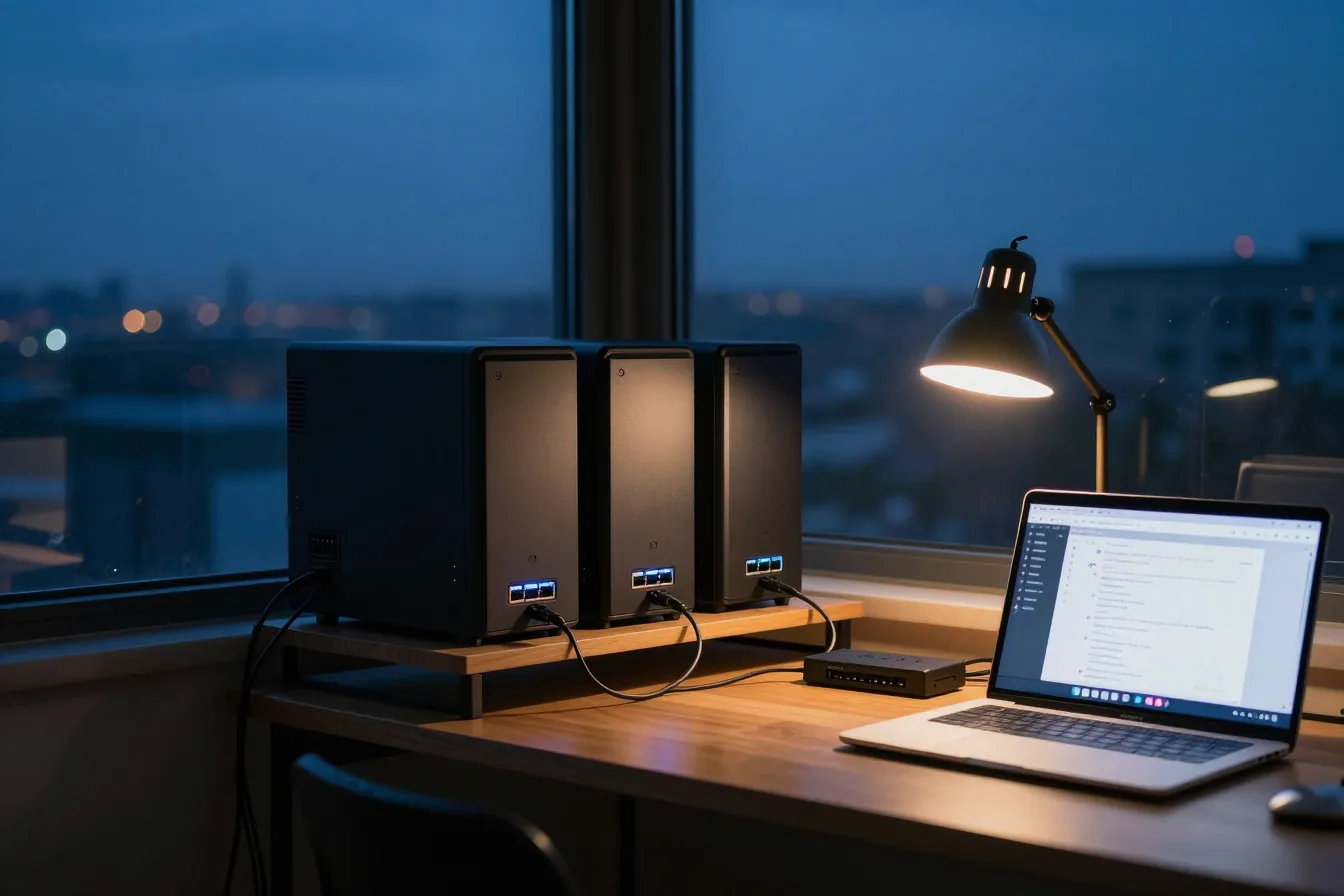
U mnie wygląda to tak. Mam trzy komputery, których używam wyłącznie do pracy ze sztuczną inteligencją. Dwa z nich są ze sobą połączone i działają jak jedna maszyna. To na nich stoi model językowy, w tej chwili GLM 5.3 Flash, otwarty model, który każdy może pobrać i uruchomić u siebie. Trzeci komputer jest od wszystkiego innego: raz generuje obrazy, raz dźwięk, raz wideo, zależnie od tego, co akurat jest potrzebne, a między tymi zadaniami przełączają go moi agenci, bez mojego udziału.
Dwa komputery połączone w jedną maszynę z modelem językowym, trzeci od obrazów, dźwięku i wideo.
Opisany powyżej zestaw wykonuje u mnie codziennie sporo pracy. W nocy przetwarza setki stron dokumentów, w dzień odpowiada na pytania, pisze raporty i przygotowuje materiały. Nie płacę za każde zapytanie, a prąd, który zużywają komputery, kosztuje mnie mniej, niż wyniósłby rachunek za tokeny kupowane przez API. Nie mam w domu najmocniejszego modelu na świecie, a mimo to większość rzeczy, które chciałem zautomatyzować, po prostu działa i jestem z wyników zadowolony. Trudno mi o lepsze potwierdzenie tego, od czego zacząłem: najlepszy model nie jest potrzebny do bardzo wielu zadań.
Jak wybieram model: testy na własnych zadaniach
Napisałem, że w tej chwili korzystam z GLM 5.3 Flash, bo co jakiś czas sprawdzam, co nowego pojawiło się na rynku, i testuję, czy któryś z nowych modeli poradzi sobie z moimi zadaniami lepiej niż ten, którego aktualnie używam. Nie sugeruję się przy tym rankingami ani testami opublikowanymi przez kogoś innego, bo te potrafią mieć niewiele wspólnego z tym, jak model poradzi sobie z moim konkretnym zadaniem. To, że gdzieś jest opisany jako świetny w czytaniu plików PDF, wcale nie znaczy, że poradzi sobie z moimi plikami PDF, o swoistym układzie, nietypowym szablonie i wyjątkowo skomplikowanym nazewnictwie. Sprawdzam więc na swoich zadaniach i jeśli nowy kandydat wypada lepiej, bo jest szybszy, dokładniejszy albo potrzebuje mniej zasobów, to go podmieniam.
Wspominam o tym, bo kilka razy spotkałem się z opinią, że wdrożenie to coś, co robi się raz i czego potem się nie dotyka. Model, który wybierzesz dzisiaj, po jakimś czasie może mieć następcę, który zrobi to samo szybciej, dokładniej albo mniejszym kosztem. Wtedy warto znów przejść przez testy i ocenić, czy podmiana się opłaca. Nie zawsze się opłaci, ale samo sprawdzenie, co się w międzyczasie zmieniło, uważam za część utrzymania takiego systemu, a nie za osobny projekt.
Kiedy lokalny model nie wystarczy
Nie chcę przy tym powiedzieć, że mniejszy model jest w stanie rozwiązać wszystkie problemy. Istnieje cała klasa zadań, z którymi lokalne modele u mnie sobie nie radzą, i nie sądzę, żeby to się szybko zmieniło: bardzo złożone problemy, zadania wymagające długiego i precyzyjnego rozumowania, sytuacje, w których model musi ogarnąć naraz ogromną ilość informacji. Do takich rzeczy dużo lepiej sprawdzi się model pokroju Claude Opus 5, Claude Fable 5.1 czy jednego z najnowszych modeli GPT, i ja sam do takich zastosowań z tych modeli korzystam: moim głównym narzędziem na co dzień jest Claude Code, w subskrypcji (to narzędzie najbardziej mi po prostu odpowiada; to prywatna preferencja, nie rekomendacja), natomiast do prostszych, powtarzalnych zadań i do wielu automatyzacji lokalny, mniejszy model (jak GLM 5.3 Flash) w zupełności mi wystarcza. Nie potrzebuję drogiego i dużego modelu, żeby odczytać dane z faktury albo wartości odżywcze z opakowania produktu.
Dane nie opuszczają firmy
Lokalne modele mają jeszcze jeden atut, o którym tylko wspomnę, bo wydaje mi się, że temat ten zasługuje na osobną notatkę: dane nie opuszczają firmy. Model działający w chmurze (niezależnie od umów i oświadczeń dostawcy) wymaga wysłania danych gdzieś dalej, często poza Unię Europejską, gdzie zasady ich ochrony mogą być inne niż u nas. Model lokalny da się ustawić tak, żeby całe przetwarzanie odbywało się w sieci wewnętrznej, bez wysyłania czegokolwiek do internetu. W branżach takich jak medycyna, prawo czy księgowość bywa to argumentem ważniejszym niż koszt.
Sam model to nie wszystko
Jeśli myślisz o wdrożeniu AI u siebie (a dokładniej: o automatyzacji opartej o AI), to musisz wiedzieć, że choć wybór modelu ma duże znaczenie, bo są modele lepsze i gorsze, to sam model nie decyduje o powodzeniu całości. Bardzo dużo zależy też od tego, jak poukładany jest proces wokół niego: jak formułowane są polecenia, które do niego trafiają, jakie dane dostaje do dyspozycji i czy są uporządkowane, czy jest ich dużo, czy mało, czy odpowiedzi są w jakikolwiek sposób kontrolowane (przez kolejny model, zwykły kod, człowieka na końcu procesu) i jak kosztowny może być błąd, bo od tego zależy, ile takiej kontroli w ogóle potrzebujesz. Wszystko to składa się na wynik, a z mojego doświadczenia wynika, że gdy te elementy są na miejscu, mniejszy model wystarcza znacznie częściej, niż większość ludzi zakłada.
W skrócie
- Najmocniejsze modele wymagają sprzętu, prądu i warunków, które dla większości firm są poza zasięgiem. Dlatego korzysta się z nich przez internet i płaci za każde zapytanie.
- Wiele zadań, które firmy chcą zautomatyzować, jest prostych i powtarzalnych. Z mojego doświadczenia wynika, że mniejsze modele radzą sobie z nimi przyzwoicie, a można je uruchomić na sprzęcie znacznie bardziej osiągalnym.
- Model lokalny daje pełną kontrolę nad danymi, bo nic nie musi opuszczać firmowej sieci.
- Sam model to nie wszystko: liczy się też, jak formułowane są polecenia, czy odpowiedzi są kontrolowane i ile może kosztować błąd.