Notatka · Automatyzacja · 9 min czytania
Osiem filmów i czterdzieści zasad
Zbudowałem proces, który ogląda filmy na YouTube i zapisuje z nich zasady dla moich agentów AI. Najwięcej pracy wymagało nie samo wydobycie wiedzy, tylko sprawdzenie, czy w filmie naprawdę pada to, co z niego wyciągnięto.
Sporo rzeczy, które dziś umiem, nauczyłem się z filmów na YouTube, i w pewnym momencie zadałem sobie pytanie, czy tak samo mogą się uczyć moi agenci (programy oparte na modelach językowych, które samodzielnie wykonują dla mnie konkretne zadania). Powód był konkretny: mam automatyzację, która rysuje małe animacje w stylu pixel art (obrazki złożone z widocznych, kwadratowych pikseli, jak w starych grach), i jej wyniki były poprawne, ale dość płaskie, więc chciałem je poprawić. Po obejrzeniu jednego odcinka o pixel arcie na YouTube uznałem, że zamiast ręcznie dopisywać wskazówki dla moich agentów, może da się zbudować proces, który zrobi to sam, bez mojego udziału: proces dostawałby link do filmu, playlisty albo całego kanału, a oddawałby zestaw zasad zapisany w pliku, po który agenci mogliby sięgnąć za każdym razem, gdy dostaną zadanie z tej dziedziny.
Jak działa narzędzie: od filmu na YouTube do zasad dla agenta
Na tej podstawie razem z Claude Code zbudowałem narzędzie, w którym ja wybieram tylko filmy (proces pokazuje mi listę razem z łącznym czasem wszystkich nagrań, zanim cokolwiek zostanie pobrane), a resztę robią agenci i „zwykły” kod. Z każdego filmu pobierane są napisy, a jeśli film ich nie ma, nagranie trafia do modelu rozpoznającego mowę, który działa na moim domowym serwerze. Do tego proces wybiera kilkadziesiąt kadrów, w dużej części z momentów, w których autor mówi coś w rodzaju „jak widać tutaj”, bo w poradniku o rysowaniu sporo wiedzy jest w obrazie, a nie w słowach. Potem każdy film dostaje osobnego agenta, który go „ogląda” (czyta transkrypcję i przegląda kadry) i wypisuje z niego konkretne zasady, za każdym razem z oznaczeniem miejsca w filmie, w którym dana zasada została wypowiedziana, a na końcu agent prowadzący cały proces łączy wszystkie zasady w jeden zestaw. Do tej części korzystam z modelu w chmurze (Claude Opus 5.5 w Claude Code, to prywatna preferencja, nie rekomendacja), bo uważne czytanie długich transkrypcji i porządkowanie kilkudziesięciu zasad to zadanie, przy którym sięgam po modele z czołówki, a te dają mi przy nim całkiem przyzwoite wyniki.
Cytat sprawdza program, nie model
Najwięcej pracy wymagało nie samo wydobycie wiedzy, tylko odpowiedź na pytanie, skąd mam wiedzieć, że w filmie naprawdę pada to, co agent z niego wyciągnął. Model czytający transkrypcję może napisać zgrabną zasadę, której autor w ogóle nie wypowiedział, i dołożyć do niej równie zgrabny „cytat”, dlatego każda zasada w moim rozwiązaniu musi mieć dosłowny cytat z transkrypcji i czas, w którym ten fragment został wypowiedziany, a „zwykły” program (nie model) sprawdza, czy te słowa rzeczywiście są w transkrypcji i czy padają w pobliżu podanego momentu. Zanim uruchomiłem proces na prawdziwych filmach, program dostał do sprawdzenia dwa celowo podrzucone błędy i odrzucił oba: cytat, którego w filmie nie było wcale, i drugi, prawdziwy, ale przypisany do miejsca oddalonego o jedenaście minut. Jest w tym jeden zabawny szczegół: automatyczne napisy czasem przekręcają nazwy (program do rysowania Aseprite został w nich zapisany jako „A sprite”). Agent nie może takiego błędu w cytacie poprawić (bo wtedy cytat przestaje się zgadzać z transkrypcją), więc poprawka trafia do treści zasady, a cytat zostaje taki, jak w napisach.
Zgodny cytat to jeszcze nie zgodny sens
W trakcie testów pojawił się kolejny problem do rozwiązania: okazało się, że cytat, który się zgadza, nie gwarantuje jeszcze, że zasada oddaje to, co autor przekazał w swoim nagraniu. Po pierwszym przebiegu wszystkie cytaty przeszły sprawdzenie, a mimo to zestaw zasad był bardziej stanowczy niż sama autorka: jej rada, żeby „rozważyć” cieniowanie innym kolorem, zamieniła się w zakaz używania jaśniejszych i ciemniejszych odcieni, a słowo „zazwyczaj” zniknęło z pięciu zasad. Nic nie zostało wymyślone, tylko model, porządkując zasady w krótkie polecenia, gubił po drodze zastrzeżenia, i moim zdaniem to błąd, który łatwo przeoczyć, bo każda zasada z osobna brzmi rozsądnie. Dziś każda zasada ma zapisaną siłę wziętą ze słów autora (wymóg, rozwiązanie domyślne, jedna z opcji albo kwestia gustu). Na listę kontrolną, z której agenci korzystają najczęściej, trafiają więc tylko wymogi i rozwiązania domyślne, a na końcu osobny agent (który niczego nie może zmienić) czyta każdą zasadę obok jej cytatu i ocenia, czy cytat rzeczywiście ją potwierdza. W pierwszym przebiegu ten agent uznał za dobrze poparte 7 zasad z 19, w drugim, już po zmianach, 29 z 40. To wyraźna poprawa, ale wciąż jedenaście zasad nie miało wystarczającego poparcia w cytatach, dlatego ten krok zostaje na stałe.
Podobnie było z kadrami. Raz zasada powołała się na kadr, który miał ją ilustrować, a okazało się, że kadr pokazywał płaski widok z boku, na którym w ogóle nie było widać tego, o czym mówiła autorka nagrania, bo program sprawdzał tylko, czy plik z kadrem istnieje, a nie co na nim jest. Działało to też w drugą stronę: w innym miejscu filmu cień pod literami został w nagraniu nazwany wygładzaniem krawędzi, a dopiero kadr pokazał, że to cień, i agent zapisał to jako dwie osobne rzeczy. Od tamtej pory, kiedy zasada powołuje się na kadr, dowodem jest u mnie sam obraz, a słowa są tylko jego opisem.
Osiem filmów, jedno źródło
Kolejna lekcja dotyczyła samych źródeł. Pierwszy zestaw powstał z ośmiu filmów z jednego kanału na YouTube (wszystkie były nagrane przez tego samego twórcę), więc zasada „potwierdzona w dwóch źródłach” oznaczała w rzeczywistości jedną osobę, która powiedziała to samo dwa razy, i w zestawie jest to zapisane wprost, na samej górze. Z siedmiu filmów, które proces przetworzył po pierwszym poradniku, sześć okazało się esejami, w których pixel art był tylko tematem pobocznym (psychologia koloru, czcionki, jedna konkretna gra): z 57 twierdzeń, które z nich wyciągnięto, do zestawu trafiła mniej więcej jedna trzecia, a siódmy film, w którym autorka poprawia rysunki widzów, dał 28 twierdzeń i większość nowych zasad z listy kontrolnej. Doszedłem do wniosku, że staranniejszy wybór filmów na początku będzie mnie kosztował mniej niż odsiewanie ich zawartości na końcu.
Latarnia przed zasadami i po nich
Czy to w ogóle coś dało? U mnie zasady cieniowania z pierwszego poradnika się sprawdziły. Według najważniejszej z nich każdy materiał (futro, kamień, woda) powinien mieć trzy odcienie: cień, podstawę i światło, i w moich wcześniejszych animacjach widać to było jak na dłoni, bo najładniejsza z nich (kot na poduszce) miała je wszystkie, a te najbardziej płaskie miały po jednym odcieniu na kamienie czy morze. Kiedy agenci narysowali od nowa latarnię morską, tym razem już według tych zasad, osobny model porównujący obrazki (pytany dwa razy, za drugim razem z obrazkami w odwrotnej kolejności) w obu przypadkach wyraźnie wybrał nową wersję.
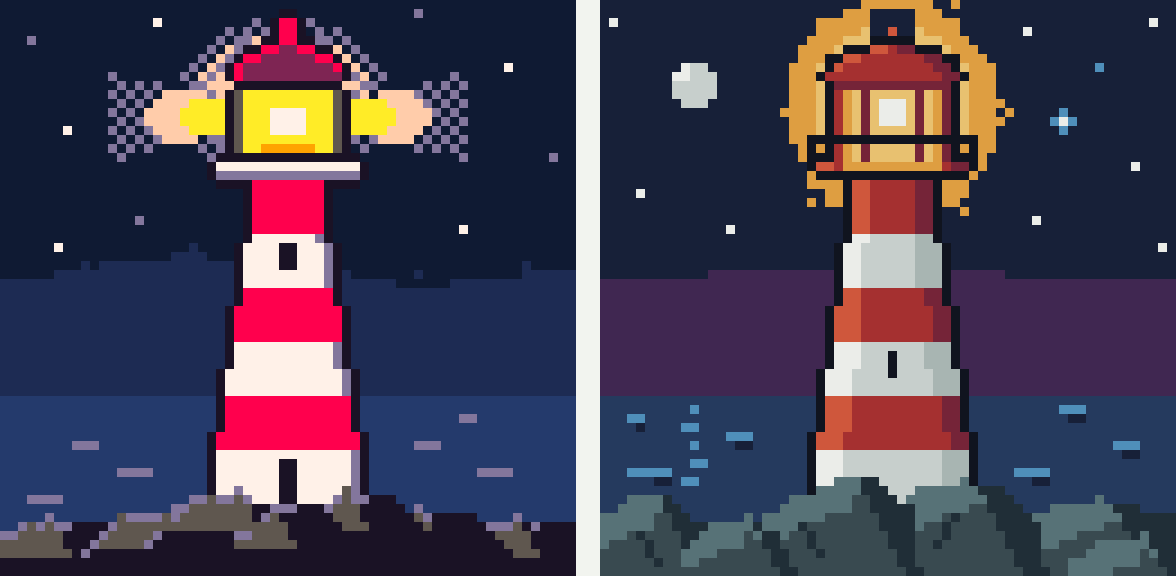
Ta sama latarnia przed zasadami z filmu i po nich: wieża ma cień i światło, a skały kilka odcieni zamiast jednego.
Gdzie zasada zawiodła
Nie każda zasada wpłynęła tak dobrze na końcowy wynik. Z filmu o kolorze wzięła się zasada, żeby jeden wyrazisty kolor zostawić tylko dla najważniejszego obiektu, i przy latarni morskiej zadziałała (wzrok od razu idzie do świecącej lampy, a obrazek przeszedł test trzy razy na trzy: osobny model, bez żadnego kontekstu, miał odgadnąć, co jest na obrazku, i za każdym razem odgadł). Przy dżungli ta sama wskazówka zawiodła w sześciu rundach z rzędu, bo to, co dostało wyrazisty kolor, stawało się odpowiedzią: wodospad brano za miecz albo fontannę, czerwone kwiaty za lisy, a smugę światła za pszczołę. Zasada została więc zawężona do pojedynczych obiektów, a w zestawie pojawiła się przy niej adnotacja, że to wniosek z moich prób, a nie z filmu. Zresztą już samo jej brzmienie było zbyt stanowcze: film opisywał, jak wzrok gracza prowadzą kolorem konkretne gry, i niczego nie radził, więc w zestawie jest dziś zapisana tylko jako jedna z opcji. Jednej zasady w ogóle nie wprowadziłem: poradniki poświęcają sporo miejsca pewnemu błędowi przy rysowaniu linii, ale narzędzie, którym rysują moi agenci, z samej konstrukcji go nie popełnia, więc sprawdzanie go byłoby pracą bez pożytku.
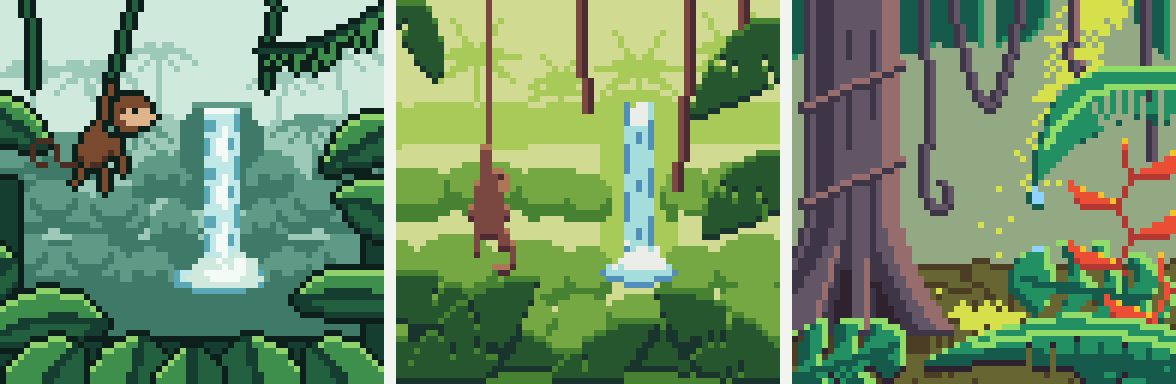
Po lewej dżungla, którą model bez kontekstu rozpoznał trzy razy na trzy. W środku wodospad przyćmił resztę i model zobaczył strumień, fontannę i miecz wbity w ziemię. Po prawej czerwone kwiaty, wzięte za roślinę w doniczce, grzyby i lisy.
Nagrania szkoleń jako źródło zasad
Pixel art jest tu przykładem celowo lekkim, bo na obrazkach najłatwiej pokazać, co działa, a co nie. Sam schemat wydaje mi się przydatny nie tylko przy pixel arcie: wiele firm ma sporo wiedzy utrwalonej w formie nagrań (szkolenia, webinary, instrukcje stanowiskowe nagrane telefonem itp.), a moim zdaniem da się je wykorzystać do przygotowania zbioru zasad, z których mógłby korzystać agent odciążający pracowników przy wykonywaniu albo sprawdzaniu części zadań, pod warunkiem że każda zasada będzie miała odnośnik do konkretnej minuty nagrania, a to, czy w nagraniu rzeczywiście pojawia się potwierdzenie danej zasady, sprawdzi „zwykły” program i osobny recenzent, a nie ten sam model, który zasadę napisał (przy nagraniach wewnętrznych dochodzi jeszcze pytanie, gdzie mogą być one przetwarzane, ale to już osobny temat).
Automatyzacja, której nie buduje się raz
Nie chcę przy tym zostawić wrażenia, że automatyzacja to coś, co buduje się raz: sprawdza się, że działa, i przechodzi do następnej rzeczy. U mnie tak to nie wygląda, a przy nauce z filmów widać to chyba najlepiej. To, co dziś mam, to pierwszy krok, który do części zastosowań działa już wystarczająco dobrze (przy niektórych animacjach zasady z filmów sprawdziły się świetnie, a przy dżungli jedna z nich zawiodła), ale czterdzieści zasad od jednej autorki to wciąż punkt wyjścia, a nie wiedza eksperta. Żeby moi agenci rysowali lepiej, proces potrzebuje więcej materiału: ten sam temat trzeba przepuścić przez niego wiele razy, z filmami różnych autorów, a zasady sprawdzać na kolejnych własnych zadaniach, bo dopiero wtedy widać, które z nich działają słabo albo tylko w części przypadków.
Mój proces nie tworzy za każdym razem nowego zestawu, tylko dopisuje zasady z nowych filmów do istniejącego: zasada potwierdzona przez drugą osobę zyskuje na sile, sprzeczności trafiają do osobnej sekcji, zamiast po cichu nadpisywać to, co już było, a zasady, które nie wytrzymują moich prób, są zawężane (tak jak ta od wyrazistego koloru). Traktuję to więc nie jako gotowe narzędzie, które da mi wiedzę eksperta z dowolnej dziedziny, tylko jako proces, który trwa i z każdym przebiegiem wie trochę więcej.
W skrócie
- Zbudowałem proces, który z filmów na YouTube wyciąga zasady dla moich agentów. Ja wybieram filmy, a resztę robią agenci i „zwykły” kod.
- Każda zasada ma dosłowny cytat i czas, a to, czy cytat naprawdę jest w filmie, sprawdza program, a nie model.
- Zgodny cytat to jeszcze nie zgodny sens: porządkując zasady, model gubił zastrzeżenia autorki, więc każda zasada ma zapisaną siłę, a osobny recenzent czyta ją obok cytatu.
- Osiem filmów jednej autorki to jedno źródło, nie osiem, a eseje dały dużo mniej niż jeden film z konkretnymi poprawkami.
- Część zasad sprawdziła się u mnie od razu, a jedna zawiodła przy innym typie obrazka, więc wiedzę z filmu traktuję jako punkt wyjścia i sprawdzam ją na własnych zadaniach.
- To nie jest coś, co buduje się raz: ten sam temat przechodzi przez proces wiele razy, z filmami różnych autorów, i dopiero kolejne przebiegi pokazują, które zasady działają słabo.