50 obrazków tej samej postaci w jedną noc, na własnym sprzęcie
Jeśli zależy Ci na wielu obrazkach z jedną i tą samą postacią (np. z maskotką firmy, bohaterem kampanii albo postacią z ilustracji do produktów), to jeden udany obrazek jest dopiero początkiem, bo potem potrzebujesz kolejnych, na których wciąż widać tę samą postać, z tą samą twarzą, w tym samym stroju i w tym samym stylu, tylko w innej pozie i w innej sytuacji. Sprawdziłem, ile z tej pracy da się zrobić na własnym sprzęcie: z jednego obrazka, który wybrałem na wzór (borsuk w żółtym rozpinanym swetrze), w ciągu jednej nocy powstało 50 kolejnych obrazków tej samej postaci, które przeszły automatyczną kontrolę jakości. Modele AI, które wymyślały sceny, rysowały i oceniały obrazki, działały u mnie w domu, a sam proces nie wysłał żadnego obrazka do zewnętrznego dostawcy. Nie płaciłem też za żadne zapytanie (sprzęt i prąd to osobny koszt), ale... z lokalnym modelem, który ocenia obrazki, cała praca idzie dużo wolniej niż z modelem w chmurze (w pierwszej takiej serii ok. 8,7 minuty na jeden zaakceptowany obrazek, wobec ok. 2,4 minuty z Claude). Ostatnie słowo przy wyborze i tak należy do człowieka: rano zostawiłem 35 z tych 50 obrazków.
Utrzymanie wyglądu jednej postaci na wielu obrazkach to zresztą znany problem: w sierpniu 2025 r. Google, przedstawiając model Gemini 2.5 Flash Image, nazwał to jednym z podstawowych wyzwań przy generowaniu obrazów i przyznał, że wciąż pracuje nad jeszcze bardziej niezawodną spójnością postaci. Przy zestawie różnych obrazków wystarczy, że każdy z nich trzyma się wspólnego stylu, natomiast tutaj każdy kolejny obrazek musi się zgadzać z pierwszym. Na sprawdzaniu tej zgodności opiera się cały proces, który zbudowałem i który nazywam fabryką postaci. Przeszło przez nią po kolei kilka postaci: gołąb i kot z modelem w chmurze, wrona zarówno z nim, jak i z lokalnym, a kozioł, szop i borsuk już tylko z lokalnym.
Jak działa fabryka postaci AI
Zanim fabryka zacznie pracować sama, jest jedna decyzja, którą zostawiłem sobie: model do generowania obrazów rysuje kilka propozycji postaci według opisów, które przygotował model językowy, ten sam model językowy ocenia gotowe obrazki, a ja wybieram spośród nich wzór, na podstawie którego powstaje każdy kolejny obrazek. Od tego momentu wszystko dzieje się bez mojego udziału: model językowy dostaje wzór i opis postaci (kim jest, jak wygląda i w jakim stylu jest narysowana), wymyśla kolejne sceny, czyli pozy, czynności, miny, rekwizyty i stroje, a model do edycji obrazów rysuje każdą z nich na podstawie wzoru.
Następnie model językowy porównuje każdy obrazek ze wzorem, najpierw w całości, a potem w zbliżeniu (twarz, dłonie, kontury i to, czy postać da się czysto wyciąć), i obrazek albo zostaje zaakceptowany, albo wraca do poprawki z inaczej sformułowanym poleceniem, albo po trzech nieudanych próbach odpada. Na końcu program wycina zaakceptowaną postać z jednolitego różowego tła, na którym ją narysowano, i przenosi ją na kremowe.
Najważniejsze są tu trzy otwarte modele AI, które można pobrać i uruchomić u siebie. Do obrazków używam dwóch, bo wzór powstaje od zera, z samego opisu, natomiast każda kolejna wersja jest przerysowaniem gotowego wzoru: wzór robi Z-Image-Turbo (od Alibaba Group), który tworzy obrazek na podstawie opisu tekstowego, a kolejne wersje FLUX 3 Image Klein (od Black Forest Labs), który według polecenia przerabia istniejący obrazek (u mnie jest nim wzór). Sceny wymyśla i obrazki ocenia GLM 5.3 Flash (od Z.ai), model językowy, który przyjmuje też obrazki i odpowiada na ich temat tekstem.
Generowanie postaci AI w chmurze
W pierwszych wersjach fabryki pracował Claude Opus 5.5, model AI firmy Anthropic, z którego korzystałem przez API, czyli płacąc za każde zapytanie według cennika producenta: wymyślał sceny i oceniał obrazki, a rysował już wtedy Klein na moim sprzęcie. Noc z kotem dała w ten sposób 100 zaakceptowanych obrazków w 4 godziny za 13,40 dolara, czyli ok. 13 centów i 2,4 minuty na jeden obrazek. Jak na sto obrazków to moim zdaniem niewiele, ale każdy z nich (podobnie jak wzór) trafia przy tej ocenie do zewnętrznego dostawcy, bo Claude musi go zobaczyć, żeby go ocenić.
Generowanie obrazów AI lokalnie, na własnym sprzęcie
Później, przy tych samych poleceniach i tych samych zasadach oceny, zamieniłem Claude na GLM 5.3 Flash, który działa u mnie na dwóch połączonych komputerach (modele do obrazów są na trzecim). W małym teście, w którym GLM dostał do powtórzenia sześć ocen z nocy z kotem, przy których wiedziałem, co postanowił Claude (dwa obrazki zaakceptował, dwa odesłał do poprawki i dwa odrzucił), lokalny model sześć razy na sześć podjął tę samą decyzję z tego samego powodu, ale to tylko sześć ocen, więc traktuję ten wynik jako wskazówkę, a nie dowód.
Wolniej idzie nie rysowanie (to w obu wersjach robi Klein na moim sprzęcie, w ok. 40 sekund na obrazek), tylko ocenianie: w pierwszej serii z GLM (z wroną) na jeden zaakceptowany obrazek przypadło ok. 8,7 minuty, wobec ok. 2,4 minuty z Claude, a w nocy z borsukiem same oceny zajęły GLM łącznie ok. siedem godzin.
Jedno pozostało bez zmian: żaden z tych dwóch modeli prawie nie różnicuje ocen, bo zarówno u Claude, jak i u GLM mniej więcej cztery na pięć decyzji o zaakceptowaniu obrazka zapadło przy ocenie 8 na 10, więc z samej punktacji trudno wyczytać, które z zaakceptowanych obrazków są najlepsze.
Pierwsza postać w całości z lokalnych modeli AI
Kozioł i szop przeszły przez fabrykę już na samych modelach lokalnych, ale ich wzory wybierałem jeszcze spośród propozycji, które wymyślił i ocenił Claude. Dopiero borsuk powstał u mnie w domu od pierwszego do ostatniego obrazka: GLM opisał cztery propozycje, Z-Image-Turbo je narysował, GLM ocenił gotowe obrazki (pisanie i ocena zajęły mu razem 152 sekundy), a ja wybrałem drugi z czterech (ten, któremu GLM dał 10 na 10), na którym borsuk podaje herbatnika. Sama noc trwała od 18:16 do 5:04 i fabryka zaakceptowała w tym czasie 50 obrazków (36 z nich przy pierwszym rysowaniu), a 12 scen odrzuciła po kolejnych nieudanych próbach.
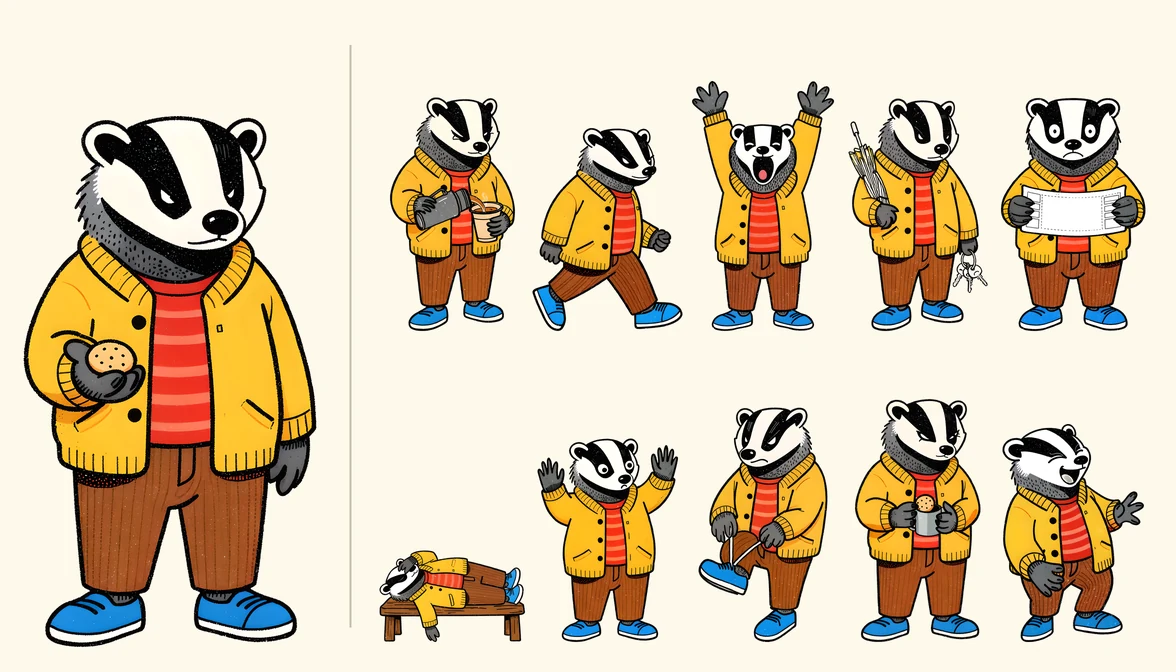
Po lewej wzór, po prawej dziesięć z 35 obrazków, które zostawiłem po nocy z borsukiem.
Gdy opis postaci nie zgadza się ze wzorem
Kozioł na wybranym wzorze trzymał kettlebell (odważnik z uchwytem) i GLM wpisał go do wszystkich 25 pomysłów na sceny (na rogu, przywiązany do drążka, przytulany jak kociak), więc ta seria została przerwana po ośmiu zaakceptowanych obrazkach. Wybrałem ten wzór ze względu na postać, a nie na odważnik, i od tamtej pory w opisie postaci jest zapisane, co na wzorze jest tylko rekwizytem, dzięki czemu w powtórzonej serii (50 obrazków w 8 godzin) kettlebell pojawił się już tylko w dwóch scenach, które były o nim (wymachy i wyciskanie).
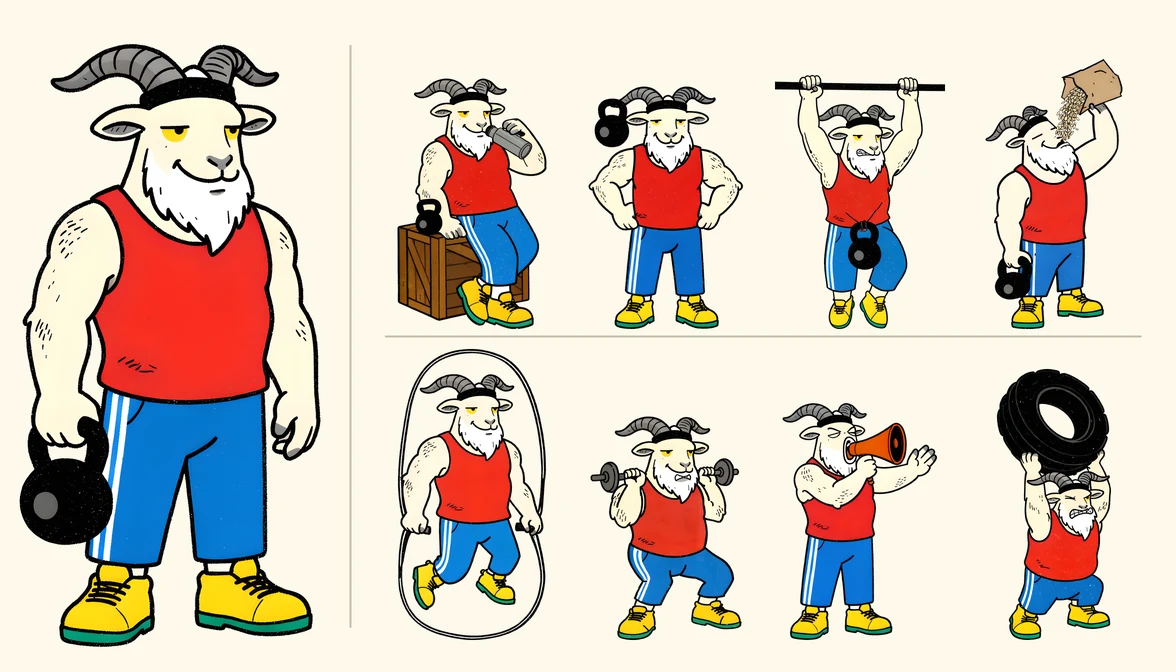
Po lewej wzór kozła, u góry obrazki z pierwszej serii (odważnik jest na każdym), na dole z powtórzonej serii, w której opis postaci mówił już, że odważnik jest tylko rekwizytem.
Przy borsuku błąd był mniej oczywisty: w opisie postaci, przepisanym po wyborze wzoru, oczy określono jako „małe, zmrużone, czarne” (w oryginale „small narrowed black eyes”), podczas gdy na wzorze to białe, zmrużone szparki z czarnymi źrenicami, wpisane w czarne pasy. GLM oceniał je według opisu, nie według obrazka: zakwestionował oczy w 27 z 56 odrzuceń (w 12 z nich nazwał je „odwróconymi”), a 7 z 12 odrzuconych scen odpadło właśnie z ich powodu. Na mniej więcej 23 z tych 27 twarzy oczy wyglądają jednak tak samo jak na wzorze, a na innych obrazkach model dokładnie takie same oczy przepuszczał (opis jest już poprawiony).
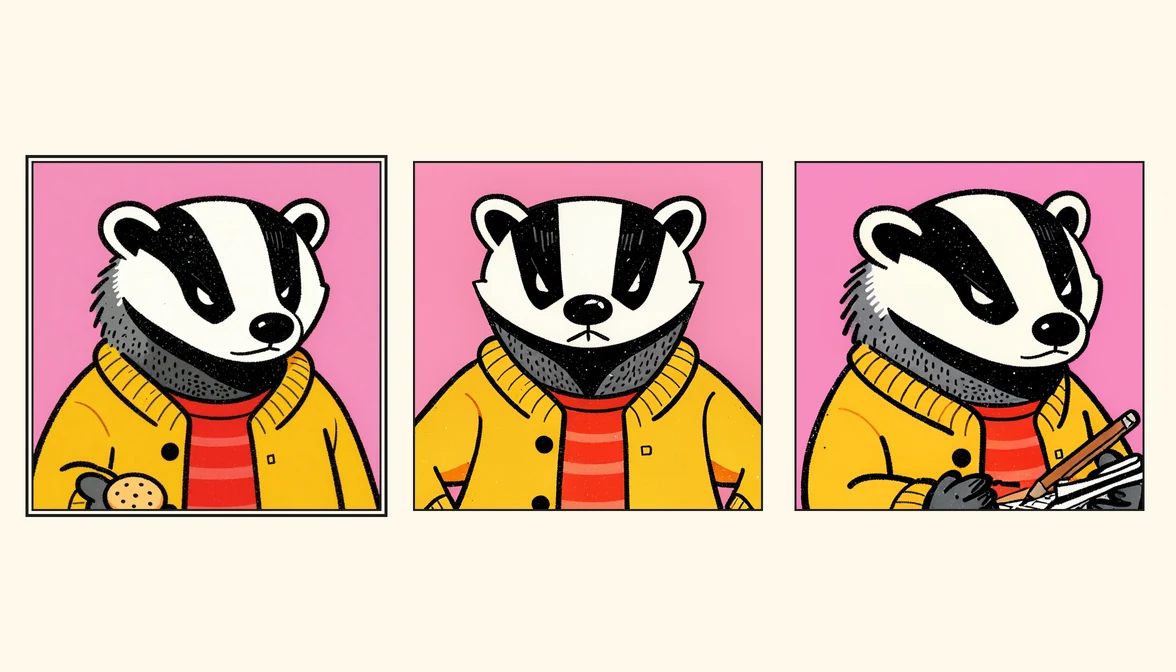
Od lewej wzór (w ramce) i dwie twarze odrzucone przez model z powodu oczu, choć oczy są na nich takie same jak na wzorze.
Ten sam model wyłapał też prawdziwe błędy (dziesięć razy białą obwódkę wokół całej postaci, jak na naklejce, a do tego m.in. napis z bezsensownych znaków na kuponie loteryjnym i packę na muchy, której nie trzymała żadna łapa), ale... przekonałem się, że automatyczna ocena potrzebuje opisu postaci zgodnego ze wzorem, bo inaczej odrzuca dobre obrazki. Wydaje mi się, że w firmie wygląda to podobnie także wtedy, gdy pracę sprawdza człowiek: jeśli w opisie maskotki jest napisane co innego, niż widać na zatwierdzonym rysunku, osoba sprawdzająca kolejne grafiki może odrzucać dobre.
Wybór obrazków wciąż należy do człowieka
W całym procesie są dwa momenty, w których decyduję ja: wybór wzoru na początku i przegląd gotowych obrazków, po którym z nocy z kotem zostały 52 obrazki ze 100, a z nocy z szopem i z borsukiem po 35 z 50. Sprawdziłem też, czy taki przegląd mógłby robić za mnie mały, szybki model AI, ale na zaakceptowanych przez Claude obrazkach z nocy z kotem (część z nich zostawiłem, część usunąłem) dwa takie modele, uruchomione lokalnie, odróżniały moje wybory od odrzuceń na poziomie losowego zgadywania. Dla mnie to dobry przykład tego, jak dzieli się tu praca: model AI całkiem nieźle wyłapuje obrazki z błędami i może to robić całą noc, natomiast to, które z poprawnych obrazków chcę pokazać, zależy od gustu i od tego, do czego są mi potrzebne, i tę część zostawiam sobie.
Kiedy opłaca się robić maskotkę z AI na własnym sprzęcie
Zakładam, że taki proces najbardziej przyda się tam, gdzie marka ma swoją postać i potrzebuje jej w wielu różnych sytuacjach (w postach, reklamach czy na opakowaniach): kolejne obrazki powstają wtedy w nocy, bez nadzoru, a rano zostaje tylko ich przegląd. Lokalnie zrobiłbym to wtedy, gdy postać albo dane nie powinny wychodzić poza firmę, a w chmurze wtedy, gdy liczy się czas.
Według producentów do samego rysowania wystarczy karta graficzna do zwykłego komputera (Z-Image-Turbo ma się mieścić w 16 GB pamięci karty, a Klein w lżejszej wersji działać na kartach NVIDIA GeForce RTX z 8 GB), natomiast model językowy, który ocenia obrazki, jest znacznie większy: GLM 5.3 Flash ma 320 mld parametrów (czyli liczb, z których składa się model) i to on zajmuje u mnie dwa komputery. Jedno zastrzeżenie dotyczy Kleina: jest udostępniony na licencji, którą producent nazwał „FLUX Kommunity License” (właśnie przez „K”), a według niej za darmo wykorzystywać obrazki komercyjnie mogą tylko osoby i firmy, które razem z podmiotami powiązanymi mają mniej niż 5 mln dolarów rocznego przychodu. Większe firmy mogą wykupić od producenta licencję na uruchamianie modelu u siebie albo korzystać z niego przez API producenta. Licencja nie rozstrzyga natomiast wprost, czy z obrazków zrobionych przez mniejszą firmę może potem komercyjnie korzystać większy klient, więc ja w takiej sytuacji zapytałbym prawnika.
Zdaję sobie sprawę, że lokalne modele do obrazów raczej nie dorównają najlepszym płatnym (np. GPT Image czy Midjourney), ale tak jak przy generowaniu tekstu, nie zawsze potrzebny jest najlepszy model i często wystarcza dostatecznie dobry, a w wielu przypadkach ważniejsze od samego modelu jest to, czy cały proces da się zautomatyzować i powtarzać tak, żeby za każdym razem obrazki miały ten sam styl i podobną jakość.
W skrócie
- Z jednego obrazka borsuka, wybranego na wzór, w ciągu jednej nocy powstało 50 kolejnych obrazków tej samej postaci, które przeszły automatyczną kontrolę jakości, a wszystkie modele AI pracowały przy tym u mnie w domu, bez opłat za zapytania.
- Lokalny GLM 5.3 Flash w małym teście sześciu ocen podjął te same decyzje co Claude, ale cała praca idzie z nim dużo wolniej: w pierwszej serii z GLM na jeden zaakceptowany obrazek przypadło ok. 8,7 minuty, wobec ok. 2,4 minuty z Claude.
- Model, który ocenia obrazki, kieruje się także opisem postaci, więc ten opis musi się zgadzać ze wzorem: przy borsuku opis oczu różnił się od rysunku i model odrzucał przez to obrazki, na których oczy wyglądały tak samo jak na wzorze.
- Wybór wzoru i przegląd po nocy wciąż należą do człowieka: z 50 zaakceptowanych obrazków borsuka zostawiłem 35, a dwa małe modele AI, które sprawdziłem przy takim przeglądzie, odróżniały moje wybory od odrzuceń na poziomie losowego zgadywania.
- Moim zdaniem nocne generowanie obrazków jednej postaci najbardziej opłaca się firmie, która potrzebuje dużo materiałów z jedną powracającą postacią, przy czym lokalnie wtedy, gdy postać albo dane nie powinny wychodzić poza firmę, a w chmurze wtedy, gdy liczy się czas.
Źródła
- GLM-5.3-Flash (model card) (otwiera się w nowej karcie), Z.ai (zai-org) on Hugging Face
- GLM-5.3-Flash/FlashX - Overview (otwiera się w nowej karcie), Z.ai (developer docs)
- Tongyi-MAI/Z-Image-Turbo (model card) (otwiera się w nowej karcie), Tongyi-MAI on Hugging Face
- Z-Image - Efficient Image Generation with Single-Stream Diffusion (project page) (otwiera się w nowej karcie), Z-Image Team, Tongyi MAI, Alibaba Group
- black-forest-labs/flux-3-image-klein (model card) (otwiera się w nowej karcie), Black Forest Labs on Hugging Face
- FLUX Kommunity License v.1.0 (LICENSE.md in the model repo) (otwiera się w nowej karcie), Black Forest Labs Inc. on Hugging Face
- FLUX 3 Image Klein: open weights, 5.6B parameters (otwiera się w nowej karcie), Black Forest Labs (blog)
- Pricing (otwiera się w nowej karcie), Anthropic (Claude Platform docs)
- Introducing Gemini 2.5 Flash Image, our state-of-the-art image model (otwiera się w nowej karcie), Google Developers Blog