Na filmie nikt nie mówi, a model AI dziękuje mi za oglądanie
Na żadnym z moich 23 filmów testowych nikt nie mówi do kamery, bo to nagrania z wyjazdów, na których słychać ruch uliczny, muzykę i rozmowy gdzieś w tle, za daleko, żeby dało się z nich wyłowić słowa. Mimo to model AI, który zamienia mowę na tekst, napisał na 20 z nich „Dzięki za oglądanie!” albo „Dziękuje za oglądanie!”, kiedy miał ustawiony język polski.
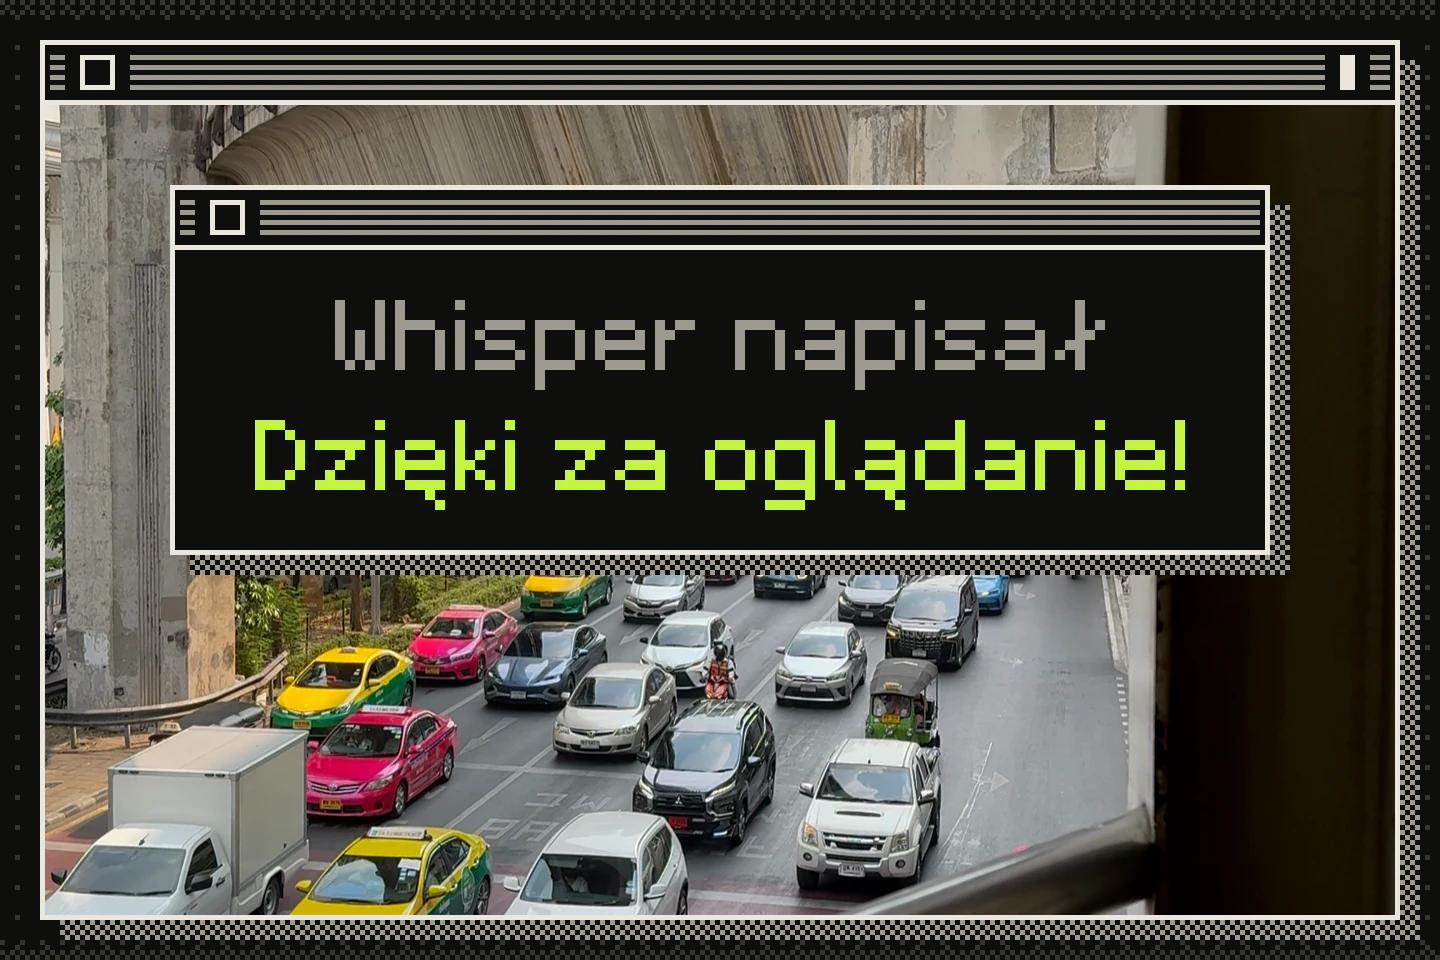
Ulica pod koleją nadziemną w Bangkoku, pełna taksówek i samochodów: model z językiem ustawionym na polski zapisał w tym miejscu filmu „Dzięki za oglądanie!”.
Kliposkop to narzędzie, które buduję od zera razem z agentami AI i które ma odczytywać z pliku wideo to, czego nie widać na samym obrazie, a w tym wpisie biorę się za mowę, czyli za to, czy ktoś na filmie coś mówi, co mówi i w której sekundzie. To pierwszy etap, na którym narzędzie korzysta z modelu AI, ale... model działa na moim Macu, więc dźwięk z filmów nie opuszcza mojego komputera.
Whisper na moim komputerze
Narzędzie korzysta z Whispera, modelu AI do zamiany mowy na tekst, który udostępniło OpenAI, a dokładniej z jego wersji large-v3-turbo (to szybsza odmiana dużego modelu large-v3). Model działa w MLX, bibliotece do uczenia maszynowego na procesorach Apple, a jego pliki narzędzie wczytuje prosto z dysku, więc przy zwykłym uruchomieniu nie łączy się z internetem i nie wysyła nawet nazwy modelu. Z filmu bierze tylko ścieżkę dźwiękową, zamienia ją w pamięci na jeden kanał (bez zapisywania pliku) i dostaje od Whispera tekst razem z informacją, w której sekundzie filmu pada każde słowo.
Na moim domowym serwerze ten sam model działa już jako usługa dla innych komputerów w mojej sieci i plan był taki, żeby narzędzie korzystało właśnie z niej. Agent AI, który pisał ten moduł (czyli tę część narzędzia), sprawdził ją jednak na nagraniu testowym, w którym po czterech sekundach szumu pada jedno zdanie, i serwer podał dla tego zdania czas od 0,0 do 3,5 sekundy. Serwer najpierw wycina z nagrania fragment, w którym wykrył mowę, i dopiero ten fragment przepisuje, więc liczy czas od początku wyciętego fragmentu, a nie od początku filmu (i nie podaje, od której sekundy zaczął wycinać). Agent uruchomił ten sam model na moim Macu i przy okazji wyszło, że sam Whisper też źle wyznacza początek: kiedy liczył czas tylko dla całego zdania, podał od 0,0 do 7,4 sekundy, a kiedy liczył go dla każdego słowa osobno, od 3,64 do 7,20 sekundy, czyli tam, gdzie zdanie naprawdę jest w nagraniu.
Prototyp podobnego narzędzia, który zbudowałem wcześniej, wysyłał dźwięk z filmów właśnie do tego serwera, a w dokumentacji prototypu jest napisane, że czas każdego fragmentu jest liczony od początku filmu, co zgadza się tylko wtedy, kiedy ktoś zaczyna mówić od razu.
Na każdym filmie coś napisał
Whisper napisał coś na każdym z 23 filmów, choć na żadnym nikt nie mówi do kamery.
Model, któremu nie ustawi się języka, sam rozpoznaje go po pierwszych 30 sekundach nagrania. Na 15 moich filmach rozpoznał angielski, na siedmiu japoński i na jednym koreański, a jego pewność wynosiła od 21 do 91%. Na pięciu filmach z japońskim napisał po japońsku podziękowanie za obejrzenie („ご視聴ありがとうございました”), na filmie z koreańskim pożegnanie, które znaczy „do zobaczenia w następnym filmie”, na pięciu innych „Thank you.”, a na pozostałych pojedyncze słowa, krótkie zdania, mieszanki słów z kilku języków i alfabetów w jednej linijce albo jedną japońską sylabę powtórzoną 223 razy. Największą pewność, 91% dla angielskiego, miał przy najcichszym filmie (ścieżka nad mokradłem w Minnesocie), na którym detektor mowy (o nim za chwilę) nie wykrył żadnego głosu.
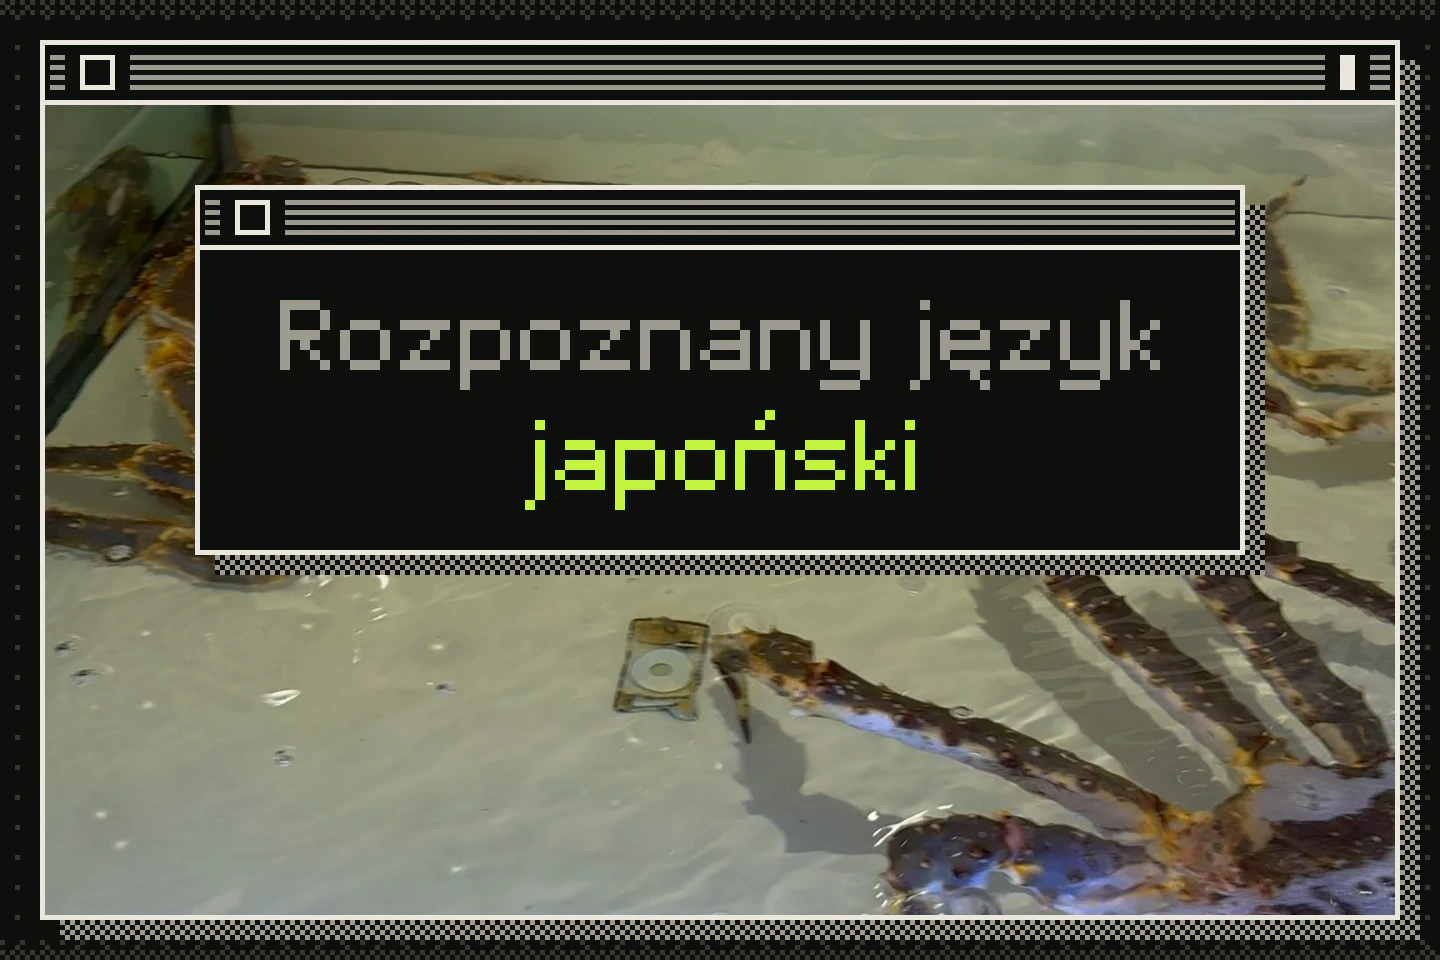
Kraby w akwarium w restauracji w Bangkoku: model rozpoznał tu japoński i napisał po japońsku podziękowanie za obejrzenie.
Whisper ma też własną ocenę tego, jak bardzo jest pewien, że w danym fragmencie nie ma mowy, ale... przy każdym fragmencie ze wszystkich trzech uruchomień (z językiem rozpoznawanym przez model, z polskim i z angielskim) ta ocena wynosiła 0,00 i przed niczym nie ostrzegła. Zdarzało mu się nawet pisać tekst, który wychodził poza koniec nagrania: na filmie, który trwa 9,2 sekundy, zapisał fragment kończący się prawie w 27. sekundzie.
Badacze z AGH w Krakowie sprawdzili, co Whisper pisze, kiedy nikt nie mówi: dali wersji large-v3 do przepisania ponad 300 tysięcy nagrań bez mowy (szumy, dźwięki miasta i otoczenia, cisza). W około 40% przypadków model coś napisał, a wśród najczęstszych tekstów były „thank you” i „thanks for watching”. Autorzy uważają, że duże znaczenie ma tu materiał, na którym Whisper się uczył: transkrypcje filmów, czyli spisany tekst tego, co w nich powiedziano (według OpenAI pierwszy Whisper uczył się na 680 tysiącach godzin nagrań z internetu razem z transkrypcjami, a obecny na ponad 5 milionach godzin).
Detektor mowy i lista gotowych zwrotów
Narzędzie nie polega na samym Whisperze: najpierw sprawdza dźwięk osobnym, małym modelem AI, Silero VAD, czyli detektorem mowy, który nie zapisuje słów, tylko wskazuje, w których sekundach słychać czyjś głos (on też działa na moim Macu). Fragment od Whispera narzędzie uznaje za mowę dopiero wtedy, kiedy detektor usłyszał w nim głos. Odrzuca go też, jeśli jest jednym z gotowych zwrotów, które Whisper dopisuje do szumu (na liście są podziękowania, pożegnania i napisy końcowe w dziesięciu językach), jeśli model sam ocenił go jako bardzo niepewny, jeśli się zapętla albo powtarza w kilku fragmentach, albo jeśli wychodzi poza koniec nagrania. Odrzucone fragmenty zostają w wyniku razem z powodem odrzucenia, a film dostaje oznaczenie, że model napisał coś, co prawdopodobnie nie jest mową.
Detektor usłyszał głos tylko na jednym z 23 filmów, przez 0,51 sekundy. Z 41 fragmentów, które Whisper napisał na tych filmach, kiedy sam rozpoznawał język, narzędzie zostawiło jeden, a pozostałe 22 filmy dostały wynik „brak mowy”. Ta reguła ma swoją cenę, bo jeśli ktoś naprawdę powie do kamery samo „dziękuję”, ono też zostanie odrzucone, tak samo jak słowo, przy którym detektor nie usłyszy głosu.
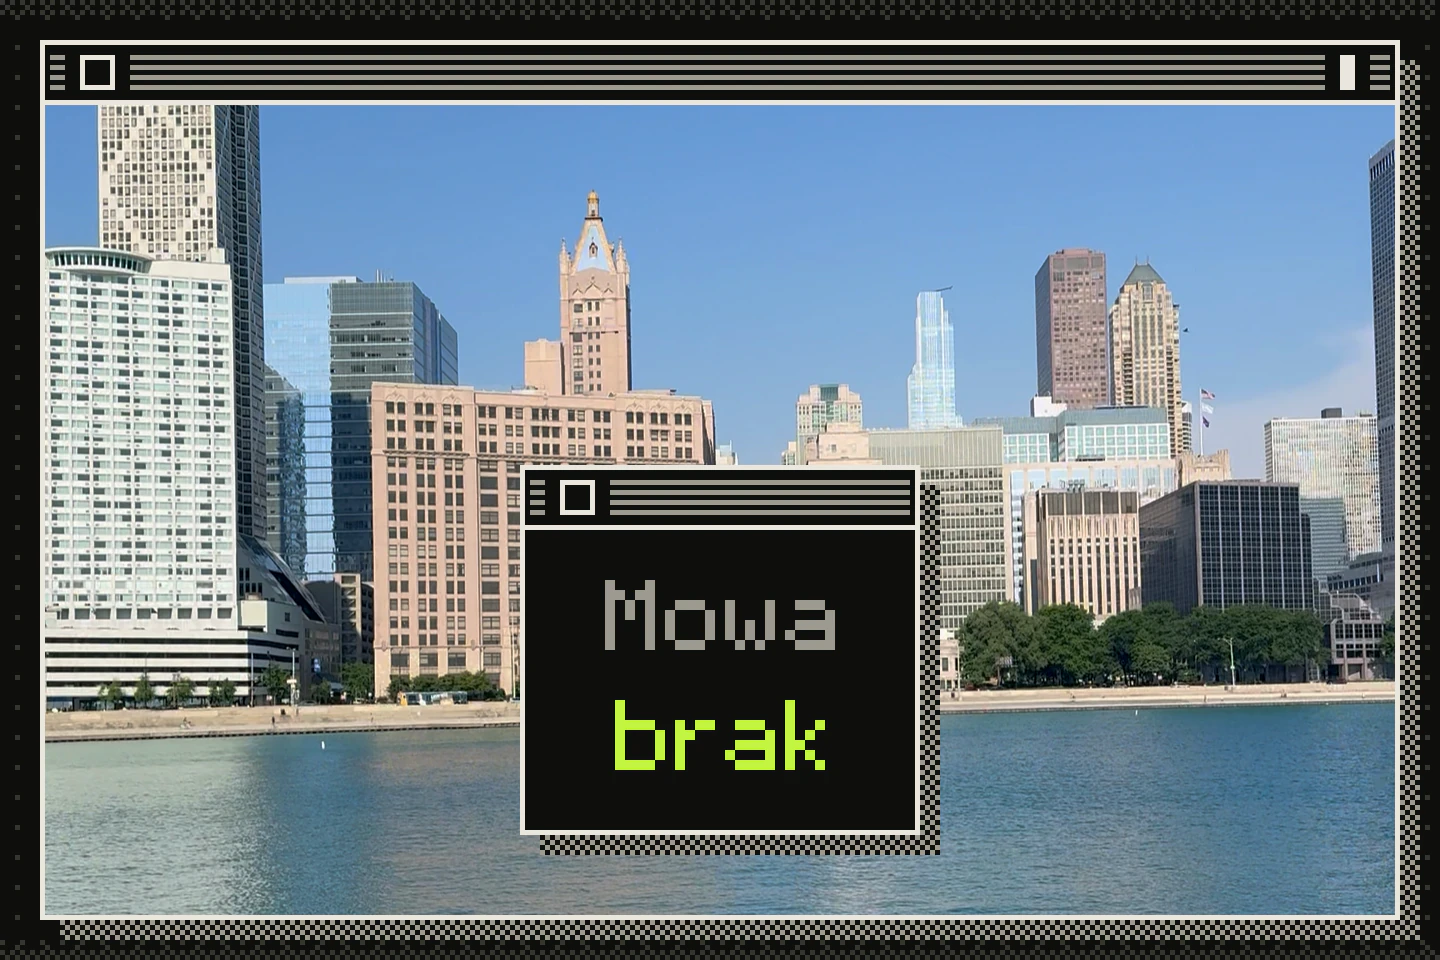
Wieżowce Chicago nad jeziorem Michigan: detektor mowy nie wykrył tu żadnego głosu, dlatego narzędzie odrzuca to, co napisał Whisper, i podaje, że na filmie nie ma mowy.
Brakujące „ę”
Pierwsza wersja reguły przepuściła jedną halucynację, czyli tekst, którego w nagraniu nie ma. Na wieczornym filmie z ulicy w Chicago Whisper z językiem polskim napisał „Dziękuje za oglądanie!” (bez „ę” na końcu) jako jeden fragment na całą długość nagrania, a na liście gotowych zwrotów to zdanie było zapisane poprawnie, więc reguła go nie wyłapała. Fragment obejmował też te 0,51 sekundy, w których detektor usłyszał głos, więc narzędzie uznało go za mowę. Znalazł to agent AI, kiedy porównywał zapisany tekst z pomiarami dźwięku i klatkami z filmów, i tego samego ranka narzędzie dostało poprawkę: lista uwzględnia teraz pisownię Whispera, a reguła uznaje za gotowy zwrot każdy fragment, w którym pojawia się „za oglądanie”.
Jedyny zachowany fragment to pewnie piosenka
Na tym samym filmie z Chicago (11 lipca 2025, 20:31, ulica, po której przejeżdża motocykl) narzędzie zostawiło jeden fragment, kiedy Whisper sam rozpoznawał język: kilka angielskich słów, które trwają półtorej sekundy i zachodzą na chwilę, w której detektor usłyszał głos. Agent sprawdzał nagrania też klasyfikatorem dźwięków (modelem AI, który rozpoznaje rodzaj dźwięku, na przykład mowę albo muzykę), a według niego w tych sekundach jest trochę więcej muzyki niż mowy, więc najpewniej to słowa piosenki z przejeżdżającego pojazdu. Reguła nie odróżni śpiewu od mowy, bo Whisper zapisuje słowa piosenki tak samo jak słowa rozmowy, a jeśli to rzeczywiście piosenka, narzędzie podaje tu błędny wynik.
Agent AI napisał ten moduł w dziewięć minut
Pracą kierował agent AI, który przekazał zadanie drugiemu agentowi, a ten w ciągu około dziewięciu minut napisał moduł razem z 50 testami. Potem sam zestawił to, co zapisał Whisper, z pomiarami dźwięku (głośność, detektor mowy, klasyfikator dźwięków) i z klatkami filmów, znalazł brakujące „ę” oraz zapętlone słowa rozbite na kilka fragmentów i poprawił regułę, a po poprawce moduł miał 61 testów. Całe narzędzie ma teraz 285 testów, które nie wykazują żadnych błędów.
Agent oceniał dźwięk na podstawie pomiarów, nie ze słuchu, a ja wyników tego etapu jeszcze nie sprawdzałem.
Na tym etapie Kliposkop zamienia na moim komputerze mowę z filmu na tekst i podaje, w której sekundzie pada każde słowo, tylko że na moich filmach testowych najwięcej pracy wymagało nie samo przepisywanie, ale odsiewanie tego, co model napisał, choć w nagraniu tego nie było.
W skrócie
- Kliposkop zamienia mowę z filmu na tekst modelem Whisper large-v3-turbo i przy każdym słowie podaje, w której sekundzie filmu ono pada, a model działa na moim Macu, więc dźwięk nie opuszcza komputera.
- Na żadnym z 23 filmów testowych nikt nie mówi do kamery, ale Whisper napisał coś na każdym: z językiem polskim na 20 z nich „Dzięki za oglądanie!” albo „Dziękuje za oglądanie!”, a kiedy sam rozpoznawał język, między innymi japońskie podziękowanie za obejrzenie i koreańskie pożegnanie z filmów w internecie.
- Własna ocena Whispera, jak bardzo jest pewien, że w danym fragmencie nie ma mowy, przy każdym fragmencie wynosiła 0,00, dlatego narzędzie sprawdza mowę osobnym detektorem i odrzuca znane gotowe zwroty, pętle i tekst wychodzący poza koniec nagrania.
- Pierwsza wersja reguły przepuściła „Dziękuje za oglądanie!” bez „ę”, a agent AI sam to znalazł i tego samego ranka poprawił.
- Jedyny zachowany fragment to najpewniej słowa piosenki z przejeżdżającego pojazdu, a reguła nie odróżni śpiewu od mowy.
Źródła
- Robust Speech Recognition via Large-Scale Weak Supervision (otwiera się w nowej karcie), OpenAI (arXiv)
- Investigation of Whisper ASR Hallucinations Induced by Non-Speech Audio (otwiera się w nowej karcie), AGH w Krakowie (arXiv)
- openai/whisper-large-v3-turbo (otwiera się w nowej karcie), Hugging Face (karta modelu)
- mlx-community/whisper-large-v3-turbo (otwiera się w nowej karcie), Hugging Face (karta modelu)
- MLX (otwiera się w nowej karcie), Apple (dokumentacja MLX)
- silero-vad (otwiera się w nowej karcie), PyPI