Po co mi narzędzie, które opisze film, zanim zobaczy go duży model językowy
Jeśli pokażesz modelowi AI zdjęcie, zwykle całkiem nieźle opisze, co na nim jest (ludzi, przedmioty, krajobraz, często też napisy), ale z filmem jest już trudniej, bo film to coś więcej niż tylko zbiór klatek. Z samego obrazu nie wyczytasz na przykład, jak porusza się kamera, co słychać w tle ani kiedy dokładnie nagrano film, a miejsce model rozpozna zwykle tylko wtedy, gdy w kadrze jest coś charakterystycznego (na przykład znany budynek).
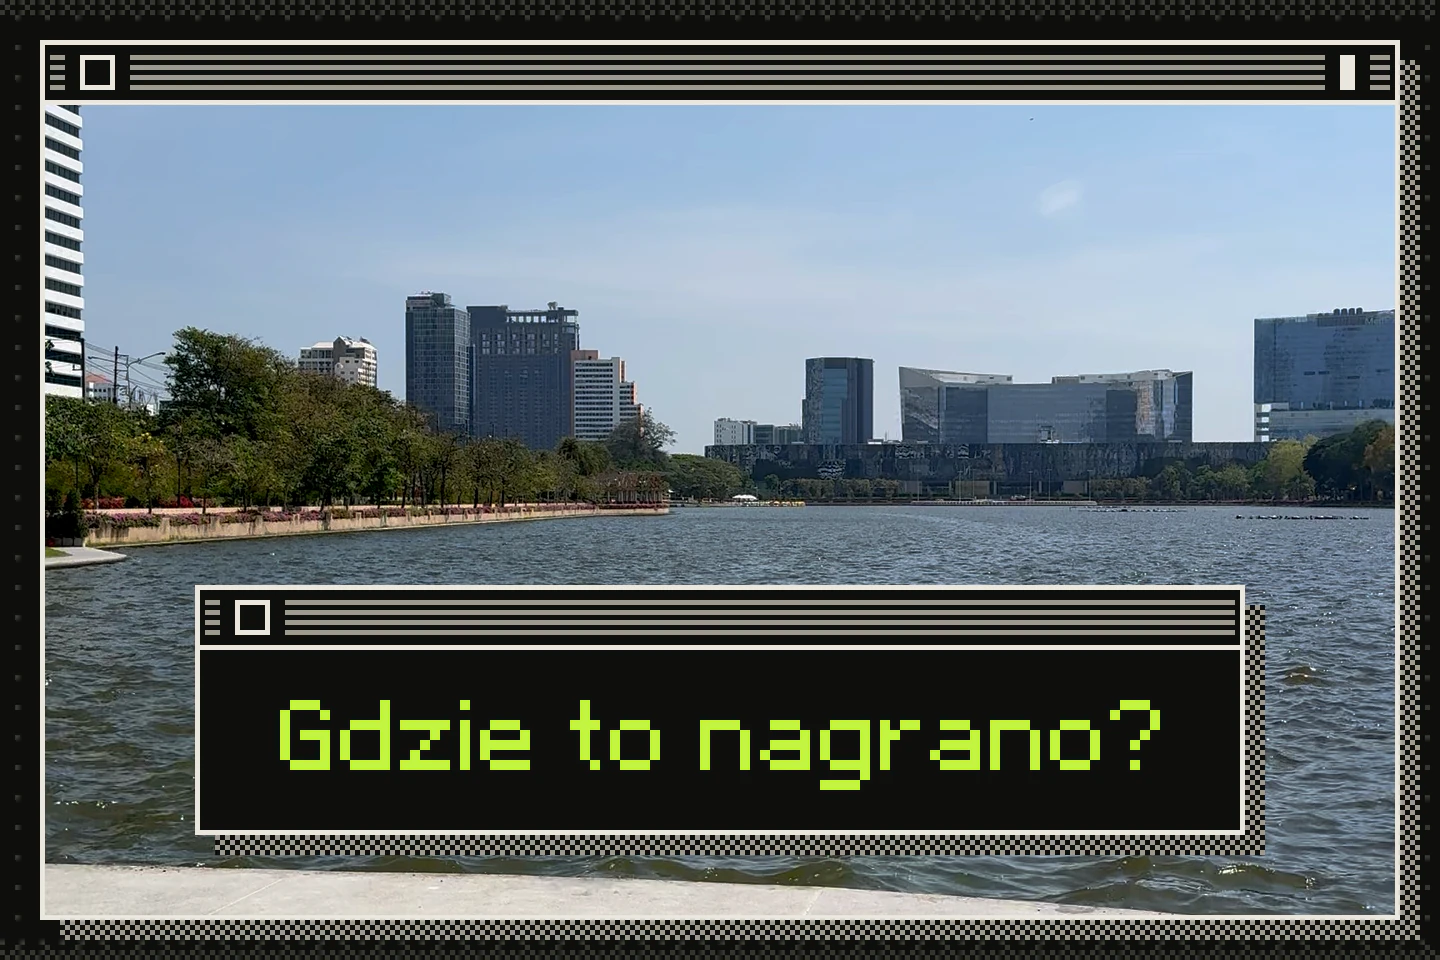
Jezioro i wieżowce w oddali, ale z samego obrazu trudno powiedzieć, gdzie to jest.
Część tych informacji telefon i tak zapisuje w samym pliku wideo, w tak zwanych metadanych (czyli danych, które są w pliku obok obrazu i dźwięku), a resztę da się odczytać z dźwięku i z tego, jak obraz zmienia się z klatki na klatkę, więc razem z agentami AI buduję narzędzie, które zbierze to wszystko, zanim film trafi do dużego modelu językowego. Roboczo nazwałem je Kliposkopem, a w tym devlogu (czyli takim dzienniku z budowy) opisuję kolejne etapy, razem z tym, co po drodze nie zadziałało.
Na tym filmie kamera powoli obraca się nad rzeką, ale z jednej klatki tego nie widać.
Dlaczego nie wystarczy duży model językowy w chmurze
Mam dwa główne powody. Pierwszy to koszt: największe modele językowe w chmurze (takie, które rozumieją też obraz i dźwięk) potrafią opisać cały film razem z dźwiękiem, ale... zużywają przy tym mnóstwo tokenów (token to taka jednostka, w której model liczy to, co przetwarza, i od której zależy rachunek u dostawcy). Google podaje na przykład, że jego modele Gemini liczą każdą sekundę filmu jako mniej więcej 100 albo 300 tokenów (zależnie od rozdzielczości klatek), czyli już minuta nagrania to od kilku do kilkunastu tysięcy tokenów. Przy jednym czy dwóch filmach to nie problem, ale moja prywatna biblioteka liczy prawie dziewięć tysięcy filmów. Gdybym chciał je wszystkie przeanalizować w chmurze, pewnie poszedłbym z torbami. Docelowo zależy mi na narzędziu, które ułatwi pracę z dziesiątkami, setkami, a może i tysiącami plików wideo. Wyciągnięcie z nich jak najwięcej informacji bez modelu w chmurze to ogromna oszczędność, przynajmniej przy dzisiejszych cenach. Chcę więc najpierw sprawdzić, ile da się dowiedzieć o filmie bez żadnych tokenów albo przy ich niewielkiej liczbie, i dopiero wtedy sięgać po duży model językowy. Nie znaczy to, że obejdę się bez AI, bo przy części analizy przydadzą się mniejsze modele AI, wyspecjalizowane w jednym zadaniu, ale takie mogą działać u mnie na komputerze.
Drugi powód jest bardziej osobisty: nie chcę wysyłać wszystkich swoich filmów do usługi w chmurze, zwłaszcza że w samych plikach są zapisane m.in. dokładne współrzędne miejsc, w których je nagrałem. Wolę narzędzie, które działa u mnie na komputerze, tylko że tu jest haczyk: modele językowe, które mogę uruchomić u siebie, są zwykle słabsze od największych modeli w chmurze, i moim zdaniem właśnie dlatego trzeba im podać lepszy kontekst (czyli więcej informacji o tym, na co patrzą). Jeśli lokalny model językowy dostanie razem z klatkami informację o tym, gdzie i kiedy nagrano film, co w nim słychać i jak porusza się kamera, to będzie miał dużo mniej do zgadywania, kiedy będzie miał ocenić, jak taki film pociąć, podzielić na fragmenty, dograć do niego narrację albo wyrównać kolory.
Jaki mam cel
Moim małym marzeniem jest biblioteka filmów opisanych tak, żeby działający lokalnie agent AI mógł na podstawie tych opisów sam wybrać nagrania pasujące do tego, czego akurat potrzebuję. Jeśli na przykład będę chciał zmontować film o zdrowym jedzeniu, wystarczy, że poproszę agenta o dobranie materiału, a on dzięki szczegółowym opisom i przemyślanym kategoriom wybierze pasujące klipy i zaproponuje albo wstępnie zmontuje wersję, którą potem sam przejrzę i ocenię. Na razie traktuję to jako kierunek, a nie obietnicę.
Prototyp podobnego narzędzia zbudowałem już wcześniej do swojego domowego archiwum (pokazuję go na stronie głównej, w części „Co już zbudowałem?”): to katalog filmów, nagrań i zdjęć, w którym pliki mają transkrypcję, tekst widoczny na ekranie, opis sceny i krótkie podsumowanie. Od tamtej pory sporo się zmieniło, i w modelach AI, i w agentach AI, z którymi programuję, więc postanowiłem zbudować to narzędzie jeszcze raz, od zera, i tym razem opisywać budowę etap po etapie. Dorzucam do niego też rozwiązania, których w prototypie nie było, dzięki czemu powinno wyjść lepsze: będzie miało więcej funkcji i mam nadzieję, że okaże się też szybsze i wydajniejsze. Agent AI, z którym to buduję, nie zagląda przy tym do starego kodu: każdy etap powstaje od nowa, a dopiero potem porównuję go z tym, jak to samo robił prototyp. Chodzi mi też po głowie, żeby kiedyś udostępnić to narzędzie innym.
Jak powstaje Kliposkop
Kod pisze głównie agent AI do programowania (u mnie Claude Code, ale to po prostu mój wybór, nie rekomendacja): opisuję mu etap, jego zakres i to, czego oczekuję, a on na tej podstawie przygotowuje kod razem z testami. Przekonałem się jednak, że agent nie zawsze zrobi sam wszystko tak, jak to sobie wyobrażam, a to, że testy nie wykazują błędów, jeszcze nie znaczy, że wynik dobrze wygląda. Każdy etap oglądam więc na prawdziwych filmach, zanim zbuduję na nim cokolwiek dalej. Takie narzędzie to zresztą połączenie wielu metod, testów i gotowych programów, a nie jeden model AI, który robi wszystko.
Do testów wybrałem 23 krótkie filmy nagrane telefonem (iPhone 15 Pro) na wyjazdach do Chicago i do Bangkoku (każdy trwa od kilku do niecałych 38 sekund). Wyciągnięcie z nich klatki to niby prosty krok, a tu już pierwsza klatka wyglądała źle: niebo prawie białe, kolory blade. Chodziło o HDR (to obraz o szerszym zakresie jasności niż zwykłe wideo): telefon nagrywa w nim filmy, a typowy sposób wyciągania klatek traktuje je jak zwykłe nagranie, i dopiero przeliczenie obrazu na karcie graficznej komputera przywróciło niebu kolor (wyszło to od razu, zanim powstał jakikolwiek kolejny etap).
Dwa kolejne błędy były bardziej podstępne, bo program w ogóle ich nie zgłaszał. Klatka przeliczana na karcie graficznej wychodziła obrócona na bok, bo telefon zapisuje film „na leżąco” i tylko dopisuje w pliku, jak go obrócić. W pierwszym podglądzie wyników budynki na odtwarzanych filmach były z kolei lekko przechylone, bo przy przycinaniu obrazu do okienka o nieparzystej szerokości program po cichu gubił jedną kolumnę pikseli. Ten sam błąd od początku ucinał jedną kolumnę w każdej pojedynczej klatce, tylko tam nie było tego widać.
Na tym etapie Kliposkop nie odczytuje jeszcze z filmu niczego nowego, bo potrafi tylko poprawnie wyciągnąć z niego klatki (i to nie od razu), ale... już samo to pokazało mi, że nawet prosty krok przy filmach z telefonu ma swoje pułapki i że wynik każdego etapu trzeba obejrzeć, zanim zbuduje się na nim następny.
W skrócie
- Modele AI dobrze opisują to, co widać na obrazie, ale z pojedynczych klatek zwykle nie odczytają, gdzie i kiedy nagrano film, co w nim słychać ani jak porusza się kamera, a część tych informacji telefon i tak zapisuje w pliku.
- Kliposkop ma zebrać o filmie jak najwięcej bez tokenów albo przy niewielkiej ich liczbie, żeby słabszy model językowy uruchomiony u mnie na komputerze dostał lepszy kontekst, a moje filmy nie musiały trafiać do chmury.
- Buduję go od zera z agentem AI, który pisze kod i testy, ale każdy etap oglądam na prawdziwych filmach, bo to, że testy nie wykazują błędów, jeszcze nie znaczy, że wynik dobrze wygląda.
- Już pierwsza klatka z filmu nagranego w HDR miała prawie białe niebo, a przy dwóch kolejnych błędach (obrócona klatka i zgubiona kolumna pikseli) program nie wyświetlił żadnego komunikatu.
Źródła
- Video understanding (otwiera się w nowej karcie), Google (dokumentacja Gemini API)